środa, 12 grudnia 2012

Problem rozwiązany przez czas

Wszyscy mówią, aby 'nie odkładać rozwiązania problemu na później', 'to co masz zrobić jutro, spróbuj zrobić dzisiaj' itd. Ja sam nie jestem specialistą od prokrastynacji, ale mam swoją metodę na rozwiązywanie problemów, a dokładnie na ich odkładanie. Nie staraj się od razu rozwiązać jakiś problem, ale ustal czy ten problem jest nieszkodliwy i niepilny. Mogą być problemy, które są nieszkodliwe i pilne (np. spóźnienie się na zajęcia, rozmowa telefoniczna z trudnym klientem), ale również mogą być szkodliwe i niepilne (np. problem w relacjach ze znajomymi, odkładanie na emeryturę). Jeżeli twój problem jest nieszkodliwy i niepilny to ustal jego ramy czasowe. Ustal do kiedy chcesz rozwiązać ten problem. Pamiętaj o tym, że każde rozwiązanie potrzebuje trochę czasu na realizację. Zapisz sobie ten problem i po jakimś czasie spróbuj powrócić do niego. Takie odkładanie problemów może spowodować, że te problemy same się rozwiążą. Czasami nie warto zamęczać się rozważaniami nad rozwiązaniem problemu. Czasami jest tak, że dany problem zostanie rozwiązany przez kogoś innego. Może się zdarzyć, że ten problem zostanie zastąpiony szkodliwszym problemem, a wtedy ten wcześniejszy przestanie istnieć.

Klasyfikowanie problemów ze względu na szkodliwość i pilność ma dużo wspólnego z macierzą Eisenhowera. Macierz(matryca) Eisenhower'a (Eisenhower matrix) można też nazywać Systemem Eisenhower’a (Eisenhower system), Siatką Eisenhower’a (Eisenhower grid), Polami Eisenhower’a (Eisenhower boxes) lub Kwadrat Eisenhower’a (Eisenhower square). Najważniejszą cechą macierzy jest pomoc w ustalaniu priorytetów w działaniach. Każdy cel, zadanie i czynność można nanieść na odpowiednią ćwiartkę.


Interpretacja macierzy jest następująca:
Ćwiartka I: rzeczy ważne i również pilne, które powinniśmy zrealizować sami lub delegować dla innych ( w natłoku innych spraw). W tej ćwiartce to zazwyczaj sytuacje nagłe, trudne do przewidzenia, lub skutki zaniedbania i niewykonywania regularnej pracy oraz sytuacje kryzysowe.

Ćwiartka II: rzeczy ważne, ale niepilne, które możemy rozłożyć w czasie lub wykonywać regularnie. Czynności, które mogłyby się znaleźć w tej części to: rekreacja, szkolenia, ćwiczenia fizyczne, przygotowania do projektu, regularna praca nad sobą.

Ćwiartka III: rzeczy pilne, jednak mało ważne – powinniśmy wykonać lub zlecić w drugiej kolejności, zaraz po zadaniach z części A. Czynności z tego obszaru nie są istotne lecz wymagają jak najszybszego wykonania, możemy do nich zaliczyć np. uregulowanie rachunków, rozmowa telefoniczna lub wizytę u znajomych

Ćwiartka IV: rzeczy mało ważne i mało pilne – po prostu możesz te rzeczy olewać. Najlepszym miejscem dla czynności z tej części jest kosz. Nie są one dla nas istotne. Zazwyczaj to one są tzw. pożeraczami czasu. Przykłady tej czynności to bezcelowe patrzenie w TV podczas nudnego programu. Zadania z tej ćwiartki można bez problemu przesunąć na dalszy plan. Odkładanie problemu nieszkodliwego i niepilnego należy do 4 ćwiartki.

Oczywiście trudno jest nakreślić uniwersalny schemat postępowania dla wszystkich ponieważ, wszystko jest uzależnione od naszych prywatnych preferencji.

Jak przyspieszyć kodowanie cz.4 (testy sparametryzowane)

To, co mi się najbardziej podoba w NUnit to 'sparametryzowane testy'. Najlepiej na przykładzie będę mógł pokazać ci piękno tego rozwiązania. Dajmy na to, że mamy klasę z 'skomplikowaną' logiką.
public class Sum
{
 public int Value1 { get; set; }
 public int Value2 { get; set; }

 public int Result
 {
    get { return Value1 + Value2; }
 }
}
Klasa Sum w polu Result zwraca sumę pól Value1 i Value2. Użycie tej klasy wygląda następująco:
var sum =  new Sum { Value1 = value1, Value2 = value2 };
sum.Result;
Stwórzmy do niego test sprawdzający działanie przykładowych liczb, dodawanie elementu neutralnego (zero) oraz dodawanie liczby przeciwnej.
        [Test]
        public void It_should_return_sum_3()
        {
            int value1 = 1;
            int value2 = 2;
            var sum = new Sum { Value1 = value1, Value2 = value2 };
            Assert.AreEqual(3, sum.Result);
        }

        [Test]
        public void It_should_return_0_because_number_of_opposing()
        {
            int value1 = 1;
            int value2 = -1;
            var sum = new Sum { Value1 = value1, Value2 = value2 };
            Assert.AreEqual(0, sum.Result);
        }

        [Test]
        public void It_should_return_0_because_adding_neutral_nuber()
        {
            int value1 = 2;
            int value2 = 0;
            var sum = new Sum { Value1 = value1, Value2 = value2 };
            Assert.AreEqual(2, sum.Result);
        }
Mamy 3 metody, które testują 3 różne przypadki. Od razu widać, że kod się powtarza, więc chcemy zredukować powtarzający się kod w tych testach. Możemy zastosować atrybut TestCase. W tym atrybucie podajemy wartości obiektów z jakimi ma być wywołana metoda. Przykład jest poniżej:
        [TestCase(1, 2, 3)]
        [TestCase(2, 0, 2)]
        [TestCase(1, -1, 0, TestName = "Because number of opposing")]
        public void It_should_return_sum(int value1, int value2, int expected)
        {
            var sum = new Sum { Value1 = value1, Value2 = value2 };
            Assert.AreEqual(expected, sum.Result);
        }
Dokładnie to mi się najbardziej podoba w NUnit. Mamy przetestowane 3 różne przypadki użycia i napisało się tylko jedną metodę. W tej metodzie 2 pierwsze argumenty atrybutu są jako dane wejściowe naszej operacji, a 3 argument jest jako wynik tej operacji. Dla poszczególnych przypadków testowych (TestCase), można jeszcze określić nazwę testu, opis, jaki wyjątek ma być wyrzucony oraz jaka wartość ma być zwracana przez tą metody. Możemy wykorzystać ten ostatni parametr.

        [TestCase(1, 2, Result = 3)]
        [TestCase(1, -1, Result = 0, TestName = "It should return 0")]
        [TestCase(2, 0, Result = 2, TestName = "Adding zero")]
        public int It_should_return_sum2(int value1, int value2)
        {
            var sum = new Sum { Value1 = value1, Value2 = value2 };
            return sum.Result;
        }
Przekształcenie bardzo przypomina 'normalną' (bez aserci) metodę, ale z atrybutami. Mam diaboliczny pomysł. Parametr Result możemy dodać do normalnej metod statycznej. W taki sposób można mieć kod implementacyjny i testy w jednym projekcie - it's crazy.

    public class SumFactory
    {
        [TestCase(1, 2,  Result = 3)]
        [TestCase(1, -1, Result = 0, TestName = "It should return 0")]
        [TestCase(2, 0,  Result = 2, TestName = "Adding zero")]
        public int Sum(int value1, int value2)
        {
            return value1 + value2;
        }
    }
To jest pierwszy przykład jak możemy wykorzystać TestCase - drugi przykład jest dla TestFixture. Napiszmy generyczną klasę, która będzie dodać 2 zmienne:

    public class GenericSum<T>
    {
        public T Value1 { get; set; }
        public T Value2 { get; set; }

        public T SumValue
        {
            get { return (dynamic)Value1 + (dynamic)Value2; }
        }
    }
I chcielibyśmy przetestować dodawanie domyślnych wartości dla zmiennych typu int i double.
    [TestFixture(typeof(int))]
    [TestFixture(typeof(double))]
    public class GenericTestNUnit<T>
    {
        [Test]
        public void It_should_return_default_value()
        {
            var sum = new GenericSum<T> { Value1 = default(T), Value2 = default(T)};
            Assert.AreEqual(default(T), sum.SumValue);
        }
    }
Argument w atrybucie TestFixture odnosi się do typu T. Takie sparametryzowane testy mają zastosowanie w testowaniu klas dziedziczących.

    public abstract class AsBiOperation
    {
        public int Value1 { get; set; }
        public int Value2 { get; set; }
        public abstract int Result { get; }
    }
    public class SumOperation : AsBiOperation
    {
        public override int Result
        {
            get { return Value1 + Value2; }
        }
    }
    public class MultiplicationOperation : AsBiOperation
    {
        public override int Result
        {
            get { return Value1*Value2; }
        }
    }
Do stworzonej klasy abstrakcyjną i napiszemy test dla wszystkich klas dziedziczących po niej. Dodatkowo mamy możliwość wprowadzenia przykładowych wartości.

    [TestFixture(1,2,3,     TypeArgs = new[] { typeof(SumOperation)} )]
    [TestFixture(0, 0,0,    TypeArgs = new[] { typeof(SumOperation) })]
    [TestFixture(-1, 1, 0,  TypeArgs = new[] { typeof(SumOperation) })]

    [TestFixture(1, 0, 0,   TypeArgs = new[] { typeof(MultiplicationOperation) })]
    [TestFixture(1, 5, 5,   TypeArgs = new[] { typeof(MultiplicationOperation) })]
    [TestFixture(5, 5, 25,  TypeArgs = new[] { typeof(MultiplicationOperation) })]    
    public class AsBiOperationTests<T>
        where T:AsBiOperation, new()
    {
        T operation;
        int _value2;
        int _value1;
        int _result;

        public AsBiOperationTests(int value1, int value2, int result)
        {
            _result = result;
            _value1 = value1;
            _value2 = value2;
        }

        [SetUp]
        public void SetUp()
        {
            operation = new T();
        }


        [Test]
        public void It_should_calculate()
        {
            operation.Value1 = _value1;
            operation.Value2 = _value2;
            Assert.AreEqual(_result,operation.Result);
        }
        
    }

Testy sparametryzowane to fantastyczne rozwiązanie, aby mniej kodować, mieć większe pokrycie kodu i móc więcej przetestować przypadków. Bardzo żałuje, że w MSTest jeszcze nie ma takiego featura (chociaż nie bezpośrednio). Jednak mam nadzieję, że w bliskiej przyszłości coś się z tym zmieni. Oprócz NUnit'a sparametryzowane test są w MBUnit.

piątek, 7 grudnia 2012

Rozpakowanie gz w PowerShell

Ostatnio miałem problem z rozpakowaniem dużej ilości spakowanych plików, wiec musiałem napisać skrypt, który będzie mógł rozpakować wszystkie pliki do wyznaczonego katalogu. Z pomocą przyszedł mi Power Shell, a skrypt wyglądał następująco:
$files = gci -Filter *.zip 
$dirInto = (Get-Location).Path
foreach ($file in $files) {
Write-Host "Processing $file"
$shell_app=new-object -com shell.application
$fileFullName = $file.FullName

$zip_file = $shell_app.NameSpace($fileFullName)
$destinationFolder = $shell_app.NameSpace($dirInto) 
$destinationFolder.CopyHere($zip_file.Items())
}
Rozwiązanie znalazłem na blogu msdn.
Wszystko ok, ale jak chciałem rozpakować pliki gz to już miałem problem. Zabrałem się za przerobienie kodu. Nie chciałem, aby rozwiązanie było uzależnione od jakieś aplikacji, na przykład od PowerShell Community Extensions
Na samym początku napisałem kod w c#, który posłużył mi za podkładke,w którym to korzystam z GZipStream.
using (FileStream fsRead =
 new FileStream(filePath, 
               FileMode.Open, 
               FileAccess.Read,
               FileShare.Read))
            {
                string fileName = 
Path.GetFileNameWithoutExtension(filePath);

                using (FileStream outFile = File.Create(Path.Combine(dirname,fileName)))

                using (GZipStream zipStream= 
new GZipStream(fsRead, 
CompressionMode.Decompress))

                    zipStream.CopyTo(outFile); //.NET 4.0
            }

Później zacząłem przerabiać ten kod na skrypt w PS.
function Unzip-Gzip
{
    param
    (
        [String]$inFile,
        [String]$outDir
    )
 
    if (! (Test-Path $inFile))
    {
        "Input file $inFile does not exist."
        exit 1
    }
 
    if (! (Test-Path $outDir))
    {
        "Output direcotri $outDir does not exist."
        exit 1
    }
   

    $inputFile = New-Object System.IO.FileStream $inFile, 
([IO.FileMode]::Open), 
([IO.FileAccess]::Read), 
([IO.FileShare]::Read)


     try{
        $newFileName = 
[System.IO.Path]::GetFileNameWithoutExtension($inFile)

        $newFilePath = 
[System.IO.Path]::Combine($outDir, $newFileName)  

        $outputDir = 
[System.IO.File]::Create($newFilePath)

        try{
            $inputFileGzip = 
New-Object System.IO.Compression.GZipStream $inputFile, ([System.IO.Compression.CompressionMode]::Decompress)

            try{
                $inputFileGzip.CopyTo($outputDir)
            }finally{
                $inputFileGzip.Close()
            }
        }finally{
            $outputDir.Close()
        }
    }finally{
        $inputFile.Close()
    }
}
Niestety nie mogłem wywołać metody CopyTo, gdyż ta metoda pojawiła się dopiero w .NET 4.0 i nie występuje w PS 2.0. Zamiast tej metody stworzyłem funkcje, która mogła przekopiować Stream.
function Copy-Stream 
{
    param
    (
        [System.IO.Stream]$inputStream,
        [System.IO.Stream]$outputStream
    )

 $bufferSize = 1024
 $buffer = New-Object byte[] $bufferSize
 
 while($true)
 {
    $byteCount = $inputStream.Read($buffer, 0, $bufferSize) 
    if ($byteCount -le 0)
    {
        break;
    }
    $outputStream.Write($buffer,0, $byteCount)
 } 
}

Ostatecznie funkcja Unzip-Gzip wyglada tak:
function Unzip-Gzip
{
    param
    (
        [String]$inFile,
        [String]$outDir
    )
 
    if (! (Test-Path $inFile))
    {
        "Input file $inFile does not exist."
        exit 1
    }
 
    if (! (Test-Path $outDir))
    {
        "Output direcotri $outDir does not exist."
        exit 1
    }


    $inputFile = New-Object System.IO.FileStream $inFile,
 ([IO.FileMode]::Open), 
([IO.FileAccess]::Read), 
([IO.FileShare]::Read)

     try{
        $newFileName =
[System.IO.Path]::GetFileNameWithoutExtension($inFile)

        $newFilePath = 
[System.IO.Path]::Combine($outDir, $newFileName) 
 
        $outputDir = 
[System.IO.File]::Create($newFilePath)
        try{
            $inputFileGzip = 
New-Object System.IO.Compression.GZipStream $inputFile, ([System.IO.Compression.CompressionMode]::Decompress)

            try{
#$inputFileGzip.CopyTo($outputDir)
#Not in POWERSHELL 2.0
                Copy-Stream  $inputFileGzip $outputDir
            }finally{
                $inputFileGzip.Close()
            }
        }finally{
            $outputDir.Close()
        }
    }finally{
        $inputFile.Close()
    }
}
A skrypt do rozpakowania plików gz wygląda następująco:
$files = gci -Filter *.zip 
$dirInto = (Get-Location).Path
foreach ($file in $files) {
Write-Host "Processing $file"
$shell_app=new-object -com shell.application
$fileFullName = $file.FullName

Unzip-Gzip $fileFullName  $dirInto
}


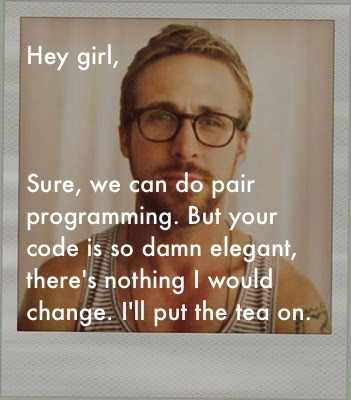
Ryan Gosling też programuje

Ryan Gosling - kanadyjski aktor, gitarzysta, a w wolnych chwilach ... programuje


I kto mówił, że język IT nie może być romantyczny :)

Więcej ciekawych zdjęć pod tym blogiem.

Ewolucja lambda expression

Na początku był delegat.


Delegat jest odpowiednikiem wskaźnika do funkcji w C/C++. Jest silnie typowany, co oznacza, że delegat może wskazywać tylko na określony typ metody. Dajmy na to, że potrzebujemy sprawdzić czy pewna wartość jest większa czy mniejsza od zadanego progu. Stwórzmy delegat, który będzie miał 2 argumenty (wartość zmiennej oraz wartość progu) i będzie zwracał bool.
delegate bool ComparisonDelegate
(int value, int threshold);


public static bool IsGreaterThan
(int value, int threshold)
{
    return value > threshold;
}


public static bool IsLessThanOrEqualTo
(int value, int threshold)
{
    return value <= threshold;
}

Zastosowanie takiego delegata wygląda następująco:

ComparisonDelegate greaterThan = 
new ComparisonDelegate(IsGreaterThan);

ComparisonDelegate lessThanOrEqualTo =
new ComparisonDelegate( IsLessThanOrEqualTo);

bool is1GreaterThan3 = 
greaterThan(1, 3);

bool is5LessThanOrEqualTo4 = 
lessThanOrEqualTo(5, 4);

Takie rozwiązanie składała się z wielu linijek kodu oraz z paru oddzielnych części (deklaracja delegata, napisanie oddzielnych metod, inicjacja instancji delegatu, wywołanie delegata).Początki są ciężkie :)
Pierwszym uproszczeniem jest zastosowanie nazwanych metod. Już nie jest potrzebne wywołanie konstruktora z parametrem do metody, tylko wystarczyło podać nazwę metody.
ComparisonDelegate greaterThan = IsGreaterThan;
W .NET 2.0 przyszedł na świat koncept zwany metodami anonimowymi.
delegate bool ComparisonDelegate(int value, int threshold);


ComparisonDelegate greaterThan = delegate
(int value, int threshold)
{
return value > threshold;
};

bool is1GreaterThan3 = greaterThan(1, 3);

Dzięki anonimowym metodom można wprowadzić logikę biznesową do 'ciała'. Już nie musimy deklarować dodatkowych metod. Skoro teraz za każdym razem kiedy tworzymy instancje używamy słowa 'delegate' to można to zamienić na znak '=>'.
ComparisonDelegate greaterThan = 
delegate(int value, int threshold)
{
return value > threshold;
};
ComparisonDelegate greaterThan = 
(int value, int threshold)=>
{
return value > threshold;
};
Od momentu zamiany słowa delegate na znak '=>' mamy do czynienia z lambda expression. Lambda expression są rozwinięciem anonimowych metod. W tym kodzie znak '=>' oznacza, że pobiera 2 argumenty typu int, a zwraca bool. Jeszcze możemy usunąć klamry:
ComparisonDelegate greaterThan = 
(int value, int threshold)=> 
value > threshold;
I skoro wiemy, że ComparisonDelegate przyjmuje dwa argumentami typu int, to możemy tą zduplikowaną informację też usunąć.
ComparisonDelegate greaterThan = 
(value, threshold)=> 
value > threshold;
Po takich operacjach, składnia jest krótsza i czytelniejsza. Całość wygląda następująco:
delegate bool ComparisonDelegate(int value, int threshold);

ComparisonDelegate greaterThan =
(value, threshold)=> 
value > threshold;

bool is1GreaterThan3 = greaterThan(1, 3);
Wraz z .NET 3.5 (c#3.0) możemy użyć generycznego delegata o nazwie Funk. Dzięki temu nie będziemy musieli deklarować dodatkowego elementu. Deklaracja wygląda następująco:
delegate bool ComparisonDelegate(int value, int threshold);

delegate TResult Func<T1, T2, TResult>(T1 arg1, T2 arg2);
Zamieniamy ComparisonDelegate na Func:
Func<int, int, bool> greaterThan = 
(value, threshold)=> 
value > threshold;
Jak widać przejście z delegatów do lambda expressions jest całkiem ... szybkie:)

czwartek, 6 grudnia 2012

Any w listach

Czasami w kodzie widzę coś takiego:
 IEnumerable<int> numbers= new List<int> { 1,2,3,11,22,33};

 if (numbers.Count() > 0)
 { 
   //code... 
 }

Nic wielkiego jeżeli mamy listę do tyś. elementów, ale co się stanie, gdy lista składa się z dużo większej liczby elementów lub elementy są jako 'ciężkie obiekty'. Metoda Count() ma liniową złożoność obliczeniową. Poniższa tabela przedstawia ilość elementów i czas działania metody Count w ms. Oczywiście na innym komputerze czas działania metody będzie inny.

CountCount time
1000
1,0000
10,0000
100,0001
1,000,00013
10,000,000130
100,000,0001332
1,000,000,00013243


Zastanawiam, się dlaczego programiści nie używają metody Any(), która ma złożoność O(1). Metoda ta sprawdza czy jest przynajmniej jeden element w liście. A co jeżeli będziemy chcieli sprawdzić czy w liście jest przynajmniej n-elementów? Ja wpadłem na parę rozwiązań.

if (numbers.Count() >= indexOf)
{
//count
}

if (numbers
.Select((x, i) => new { x, i })
.Any(arg => arg.i >= indexOf))
{
//select&any
}


if (numbers
.Skip(indexOf)
.Any())
{
//skip&any
}

if (numbers
.ElementAtOrDefault(indexOf+ 1) != default(int))
 {
 //elementAt
}

if (numbers
.Take(hasIndexes)
.Count() == indexOf)
{
//take&count
}


Zmienna indexOf określa ile elementów chcielibyśmy, aby było w liście. Metoda ElementAtOrDefault mogła by spełniać warunek zadania tylko wtedy, gdyby lista nie zawierała domyślnej wartości elementu. Poniżej przedstawiam wyniki czasu działania dla tych sposobów. Czas jest liczony w ms.

IndexOfCountSelect&AnySkip&AnyElementAtTake&Count
1282652101
10277690000
100279160000
1,000286040000
10,000284230000
100,000286053112
1,000,0002854132121421
10,000,00028408321128137205
100,000,000285293222130213902065
1,000,000,0002858332342132681378920489

Wykres w skali liniowej i logarytmicznej:


Wniosek jest taki, że najlepiej przeskoczyć potrzebną liczbę elementów w liście i sprawdzić czy jest jakiś element (skip&any).

Gdyby lista byłaby IList<T> to można jeszcze zastosować indexOf lub właściwość Count:

if (numbers
.IndexOf(hasIndexes) != -1)
{

}

Jeżeli znasz inne sposoby to opisz je w komentarzu. Jestem ciekaw co można jeszcze zrobić.

Captured variables

Chciałbym napisać o czymś co się ostatnio dowiedziałem. Kompilator C# używa delegatów nie tylko po to, aby referować do metod, ale również aby przechowywać pewien kontekst - może przechowywać zmienne, aby były dostępne przez różne metody. Przypuśćmy, że mamy taką metodę:
public static bool IsGreaterOrEqualThan(
int value, 
int threshold)
{
 return value >= threshold;
}

Metoda pobiera dwa argumenty. Pierwszy zawiera wartość jaką chcemy sprawdzić, a drugi argument określa wartość progową. Zróbmy z tego predykat - metodę, która zwróci instancje delegata.
public class Pred
{
public static Predicate<int> IsGreaterOrEqualThan(
int threshold)
{
 return value => value >= threshold;
}
}

Wywołanie wygląda następująco:
Predicate greaterorEqualThan100 =
 IsGreaterOrEqualThan(100);

bool isValue1GreaterOrEqual   = greaterorEqualThan100 (1);
bool isValue999GreaterOrEqual = greaterorEqualThan100 (999);

Wartość graniczna (threshold) nie jest argumentem wbudowanej metody (inline method), ale samego predykatu. Kiedy tworzymy instancje predykatu to .NET tworzy dodatkową 'magię'. Kompilator generuje klasę, aby mógł przetrzymywać zmienne. Ta klasa będzie zawierała metodę oraz zmienną. Każde wywołanie metody będzie miało własną wartość zmiennej threshold. Jak pokazuje refleksja, wygenerowana klasa <>c__DisplayClass1 ma nazwę niedozwolona przez c#.
 public class Pred
  {
    public Pred()
    {
      base..ctor();
    }

    public static Predicate<int> 
IsGreaterOrEqualThan(int threshold)
    {
      Pred.<>c__DisplayClass1 cDisplayClass1 = 
new Pred.<>c__DisplayClass1();

      cDisplayClass1.threshold = threshold;

      return new Predicate<int>(
(object) cDisplayClass1, 
__methodptr(<IsGreaterOrEqualThan>b__0));

    }

    [CompilerGenerated]
    private sealed class <>c__DisplayClass1
    {
      public int threshold;

      public <>c__DisplayClass1()
      {
        base..ctor();
      }

      public bool <IsGreaterOrEqualThan>b__0(int value)
      {
        return value >= this.threshold;
      }
    }
  }


Tutaj należy poruszyć dwie ważne kwestie. Uchwycone zmienne (polskie tłumaczenie Captured Variables) mogą spowodować, że kod w pętlach zacznie inaczej działać niż spodziewaliśmy się na samym początku. Po drugie, lokalne zmienne typu ValueType nie zawsze są na stosie (stack) - kompilator kopiuje lokalną zmienną (threshold) do pola obiektu, który znajduje się na stercie (heap). Ta czynność ma bardzo duży wpływ na wydajność aplikacji.